Knowledge graph aziendale: dal Graph RAG al grafo virtuale sui dati esistenti
Il Graph RAG legge un archivio di documenti, non rappresenta i dati dell'azienda. I limiti dei database a grafo, l'alternativa del grafo virtuale e le decisioni su proprietà, scrittura e accessi.
In sintesi. Il Graph RAG costruisce un grafo di ciò che dicono i documenti ed è utile per le domande che riguardano un intero archivio, ma non coincide con una rappresentazione dei dati aziendali. La difficoltà vera sta nel collegare il modello concettuale alle istanze che vivono nei sistemi, senza replicare la piattaforma dati dentro un database a grafo. Un grafo virtuale, che lascia i dati dove sono e li espone attraverso mappature, è una strada da valutare. Prima della tecnologia vengono le decisioni su chi possiede il grafo, chi può scriverci e chi vede che cosa.
Negli ultimi mesi quasi ogni proposta di architettura per agenti AI che ci capita di leggere contiene la parola grafo. Il knowledge graph viene presentato come lo strato che darà agli agenti la conoscenza dell'azienda, e il Graph RAG come la tecnica che permette di interrogarlo in linguaggio naturale. Entrambe le cose sono vere entro un certo perimetro, e conviene conoscerlo prima di approvare l'investimento.
Di ontologie abbiamo scritto più volte, dal glossario alla tassonomia fino all'ontologia aziendale come modello delle entità che contano. Qui ci interessa il passo successivo, quello in cui il modello concettuale deve incontrare i dati veri, perché è lì che i progetti rallentano e che le decisioni smettono di essere tecniche.
Il Graph RAG e il suo campo di applicazione
La tecnica è stata descritta da Microsoft Research in un lavoro dell'aprile 2024. L'idea è far leggere a un modello un insieme di documenti, estrarne entità e relazioni, raggrupparle in comunità e preparare un riassunto per ciascuna. Quando arriva una domanda che riguarda l'intero corpus, per esempio quali temi ricorrono nei verbali dell'ultimo anno, il sistema risponde dai riassunti, cosa che un recupero per somiglianza non sa fare perché nessun singolo frammento contiene la risposta.
Il limite emerso subito è il costo di preparazione, dato che ogni documento viene letto da un modello più volte. Gli stessi autori hanno presentato a novembre 2024 una variante, LazyGraphRAG, che rinvia l'estrazione al momento della domanda e porta il costo di indicizzazione allo 0,1% di quello della versione completa. Il fatto che la correzione sia arrivata dal gruppo che aveva proposto il metodo dice quanto quel costo fosse un ostacolo.
Il Graph RAG, in ogni sua variante, lavora sui documenti. Costruisce un grafo di ciò che i testi dicono, e lo fa con un modello che può sbagliare un'estrazione o fondere due entità con lo stesso nome. Resta uno strumento di lettura di un archivio, utile entro quel confine, e non coincide con la rappresentazione dei dati dell'azienda.
Lo strato concettuale e le istanze
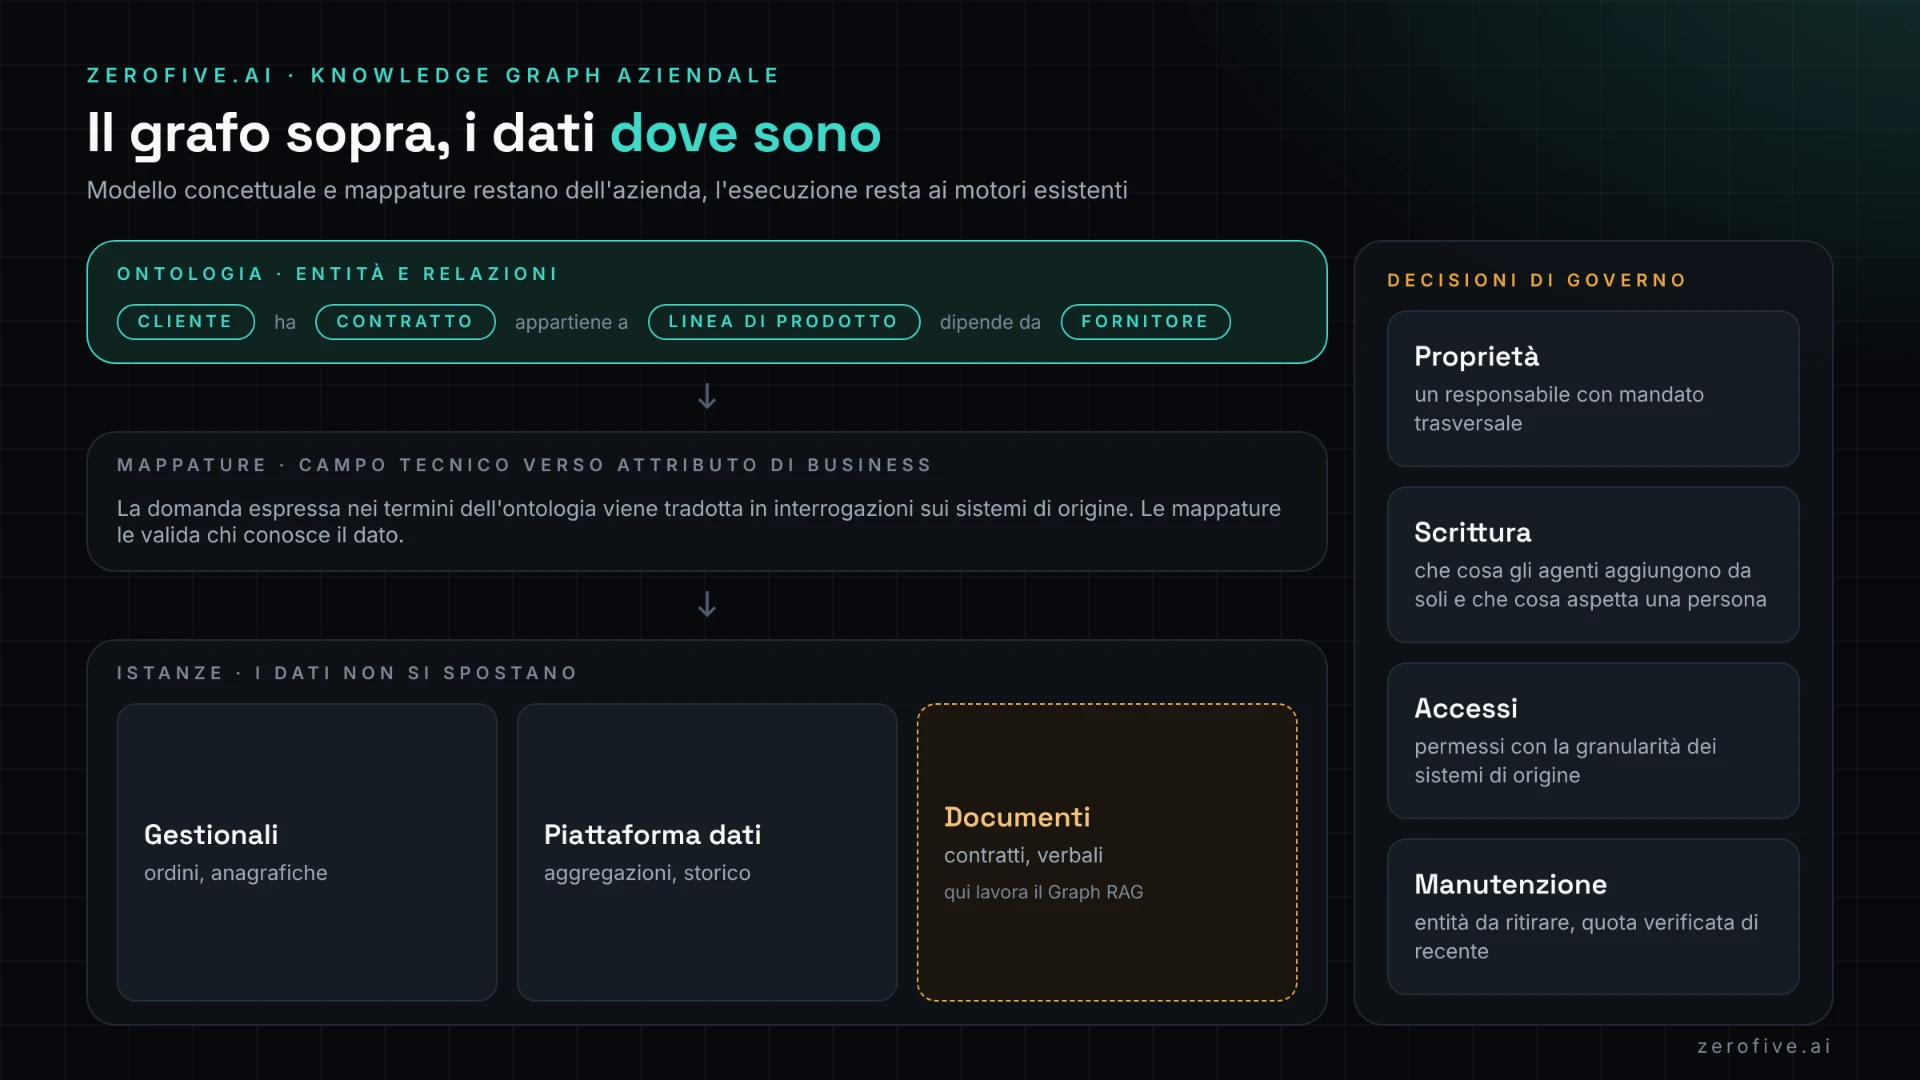
Un'ontologia descrive la superficie. Dice che esiste l'entità cliente, che un cliente ha dei contratti, che un contratto appartiene a una linea di prodotto. Chi ha lavorato con i sistemi esperti negli anni in cui le ontologie si costruivano a mano ricorda che funzionavano bene finché a mantenerle c'erano esperti di dominio, e che comunque si fermavano a quel livello, senza scendere ai dati.
Sotto la superficie ci sono le istanze, i milioni di record che vivono nei sistemi gestionali, nel data warehouse, nella piattaforma dati. Un agente a cui si chiede quali clienti sono esposti al ritardo di un fornitore ha bisogno di entrambe le cose, la mappa che gli dice come cliente e fornitore sono collegati e i dati aggiornati su ordini e consegne.
Il passaggio dall'una agli altri è il punto in cui si concentra la difficoltà. Ogni colonna di una tabella ha un nome tecnico deciso anni fa da chi ha progettato il sistema, e capire a quale attributo di quale entità corrisponde è un lavoro di riconciliazione che i modelli generativi oggi accelerano molto e che va comunque validato da chi conosce il dato. Senza quella corrispondenza l'ontologia resta un disegno.
I limiti dei database a grafo
La soluzione che viene in mente per prima è caricare tutto in un database a grafo. Chi ci ha provato su volumi aziendali conosce il risultato, perché questi motori sono molto efficaci quando la domanda riguarda la struttura delle relazioni, come riconoscere uno schema ricorrente o trovare entità simili per il modo in cui sono collegate, e lo sono molto meno sulle aggregazioni e sulle letture massive per cui le piattaforme analitiche sono state ottimizzate in vent'anni.
Replicare l'intera piattaforma dati dentro un grafo significa poi mantenere due copie allineate, con i costi e i ritardi che ogni copia comporta. Il rischio è arrivare a una mappa completa e ben disegnata che impiega minuti a rispondere a una domanda per cui il data warehouse impiega secondi.
Lo stesso ragionamento, rovesciato, vale per i database documentali, che ottengono velocità rinunciando alle relazioni e mostrano il conto quando l'interrogazione attraversa più collezioni. Ogni tecnologia è stata progettata per un tipo di domanda, e un patrimonio informativo aziendale ne pone di tutti i tipi.
Quale framework serve davvero alla tua azienda?
L'AI Rating misura la maturità sulle quattro aree del modello e indica da dove partire, con priorità e sforzo stimato.
Avvia il tuo AI RatingIl grafo virtuale sopra le piattaforme esistenti
Esiste una strada intermedia, meno nota fuori dall'ambiente accademico, che consiste nel lasciare i dati dove sono e costruire sopra di essi un grafo virtuale. L'ontologia viene collegata alle tabelle attraverso un insieme di mappature, e quando arriva una domanda espressa nei termini dell'ontologia il sistema la traduce in interrogazioni sui database sottostanti.
Uno dei riferimenti in questo campo è italiano. Ontop, sviluppato alla Libera Università di Bolzano e distribuito con licenza aperta, espone il contenuto di database relazionali come grafo di conoscenza senza spostare i dati, e nelle versioni recenti si collega anche alle principali piattaforme analitiche in cloud. Lo citiamo come esempio dell'approccio e non come indicazione di prodotto, perché la scelta dello strumento dipende da ciò che l'azienda ha già.
Il vantaggio di questa impostazione è che separa due lavori di natura diversa. Il modello concettuale e le mappature sono un patrimonio dell'organizzazione, che sopravvive al cambio di piattaforma. L'esecuzione resta ai motori che già la fanno bene. Il costo è nella scrittura e nella manutenzione delle mappature, che è esattamente il lavoro di riconciliazione descritto sopra e che non si può evitare con alcuna architettura.
Le decisioni di governo
Qualunque sia la tecnologia, un grafo di conoscenza aziendale pone domande a cui il fornitore non può rispondere.
Chi ne è proprietario è la prima. Un'ontologia che attraversa vendite, operations e finanza non appartiene a nessuna delle tre funzioni, e senza un responsabile con mandato trasversale ogni area mantiene la propria versione. Le regole di scrittura vengono subito dopo: se gli agenti possono aggiungere entità e relazioni mentre lavorano, bisogna decidere quali proposte entrano nel grafo da sole e quali aspettano l'approvazione di una persona.
Poi c'è la questione di chi vede che cosa. Lo stesso nodo può contenere informazioni che un commerciale può leggere e un fornitore esterno no, e un grafo che collega tutto rende molto facile arrivare per vie laterali a un dato a cui non si avrebbe accesso diretto. I permessi vanno portati dentro il grafo con la stessa granularità che hanno nei sistemi di origine, tema che abbiamo toccato in RAG e connettori.
C'è infine la manutenzione. Un grafo descrive l'azienda a una certa data, e l'azienda cambia. Servono un processo per ritirare le entità che non esistono più e un indicatore di quanta parte del grafo è stata verificata di recente.
Un perimetro di partenza
Nei progetti che seguiamo il consiglio è lo stesso che diamo per l'ontologia: un processo, venti entità, un responsabile. Si sceglie una domanda di business che oggi richiede di consultare tre sistemi e due persone, si modellano le entità coinvolte, si scrivono le mappature verso le tabelle che le contengono e si misura se un agente riesce a rispondere con lo stesso risultato di un analista.
Su quel perimetro ristretto si vedono subito i problemi veri, cioè i nomi dei campi che nessuno sa più interpretare, le due anagrafiche clienti che non coincidono, il responsabile che manca. Risolverli lì costa poco e produce un metodo che si può estendere al processo successivo, come descriviamo nell'articolo sull'AI Company OS.
Nell'AI Rating la presenza di un modello condiviso delle entità, con un proprietario e una procedura di aggiornamento, è uno degli elementi della dimensione Readiness. È raro trovarlo completo, ed è frequente trovare organizzazioni che hanno acquistato una piattaforma a grafo prima di aver deciso chi ne governa il contenuto. Per capire da quale processo partire potete fissare un incontro di valutazione o scriverci a hello@zerofive.ai.